LightNav-0
以规模化 Real2Sim2Real 实现零样本通用导航
要让具身基础模型在不同机器人本体、任务与场景间实现零样本泛化,需要用大规模真实世界经验进行后训练(或对齐)。遥操作是采集这类经验的主要方式之一,但要达到零样本泛化所需的规模和多样性,仍然很困难。
我们构建了 Real2Sim2Real 数据引擎,在仿真中大规模合成训练经验,替代成本高昂的真实交互采集。引擎将从互联网搜集的 2,000+ 个真实场景转化为可反复使用的仿真环境,生成 4,000+ 小时多样化的视觉—语言—动作经验,用于导航后训练。
我们用这些数据完成三个阶段的训练:具身推理(ER)中期训练、具身监督微调(SFT)和在线强化学习(RL)。由此得到的通用导航模型 LightNav-0,在涵盖指令跟随、物体目标导航和具身视觉跟踪的 10 项仿真评测中达到领先水平,并能零样本迁移至人形、四足、飞行和轮式机器人。
在 Light Origins,我们认为,通往物理世界通用人工智能(Physical AGI)的路径包括规模化预训练、规模化对齐和规模化部署。LightNav-0 是我们以 Real2Sim2Real 探索规模化对齐的第一步。它的结果表明,规模化对齐是实现物理世界零样本泛化的关键。
从真实场景中规模化生成交互经验。
具身后训练首先面临数据生产的难题。真机经验需要机器人在具体环境中一次次尝试才能积累,而泛化要求经验覆盖丰富的本体、场景和任务组合。仅靠真实世界采集,不仅成本高,速度也难以满足模型训练快速迭代的需要。
Scalable Alignment(规模化对齐)从互联网上搜集的 2,000+ 个真实场景出发。数据引擎将不同格式的场景接入统一仿真接口,让同一个场景可以用于生成多种目标、路线、视角和指令表达。生成交互数据时,相机参数也随之变化,使训练数据覆盖不同的视场角、安装高度和机器人本体。
每次仿真交互都形成一组相互对应的数据:模型看到的画面、指令所指的目标、需要关注的位置,以及应当执行的动作。让大量场景真正用于后训练的关键,是这些信息彼此对齐,而不只是渲染数量的增加。目前,引擎已生成 4,000+ 小时视觉—语言—动作经验。随后,真机部署帮助我们发现下一轮还需补充哪些场景、任务和交互。
后训练的三个阶段。
具身基础模型的后训练逐渐形成了常见的三阶段流程:领域中期训练、监督微调和强化学习。三个阶段依次推进:中期训练打好表征基础,SFT 学习如何行动,RL 再根据模型实际采取的行动及其结果改进策略。LightNav-0 将这一流程用于导航,依次进行 ER 中期训练、具身 SFT与在线 RL。
先理解空间,再学习行动。
导航轨迹数据的采集成本很高,因为每条轨迹都需要与场景、指令和动作序列对齐。不过,行动前所需的许多能力,例如在图像中定位语言描述的目标、识别可通行空间、理解空间关系和追踪变化,都可以从更大规模的图像与视频中学习。第一阶段通过中期训练建立这些空间先验,第二阶段再用轨迹数据把它们转化为动作。
Gemini Robotics1 以 Gemini Robotics-ER 为基础;MolmoAct22 则使用 MolmoER 作为视觉语言模型骨干。这两个例子都以具身推理为动作学习打下基础。LightNav-ER 在 LightNav-0 中也承担这一作用,为第二阶段提供具备空间理解能力的初始模型。在动作学习之前,它已在我们报告的八项具身推理基准评测3中取得四项第一、四项第二,八项得分的平均值为 67.4。
- 图像点定位
- 35.14%
- 单图视觉问答
- 25.05%
- 通用视觉与抽象推理
- 20.00%
- 视频推理
- 19.81%
35.14%点定位是占比最高的
专项训练数据
67.4 平均分
4 第一
4 第二
+4.3 较初始模型的提升
定位图像中的实体
文字中的目标与图像中的定位点一一对应。
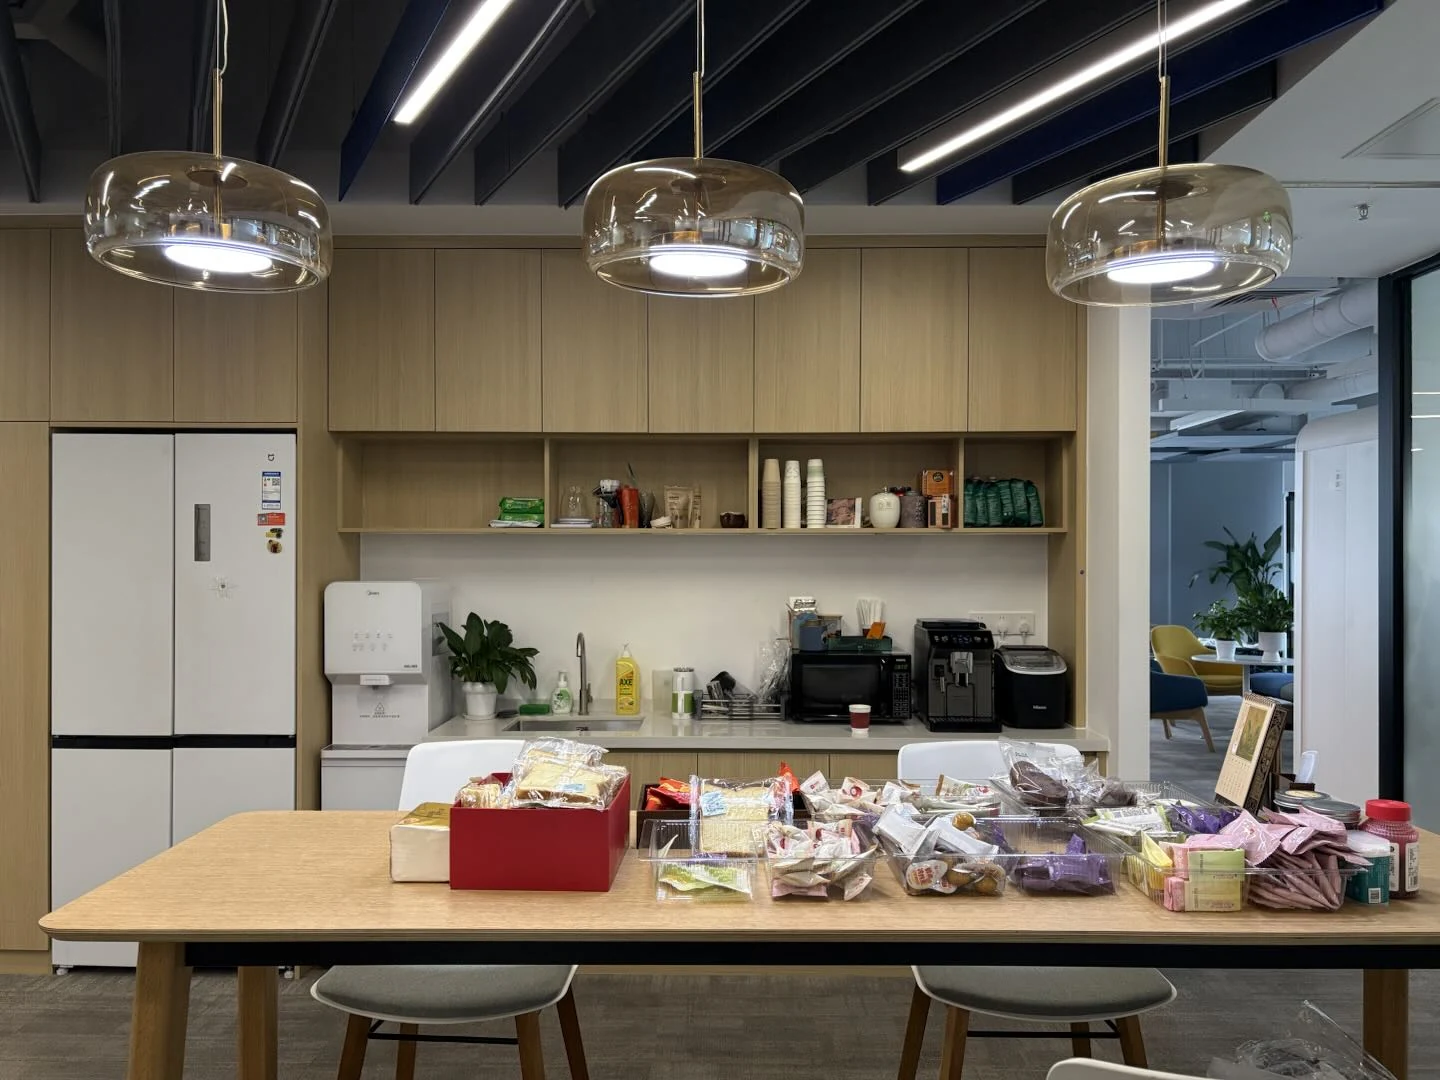
列出图中的家用电器,并指出它们各自的位置。
、 、 与 。
从场景中生成视觉、语言与动作对齐的经验。
第一阶段让模型学会理解空间,第二阶段则要让它据此行动。仅靠真机采集,很难覆盖后训练所需的场景、目标、路线和视角组合。Real2Sim2Real 让一个已经采集的场景可以反复使用,从中生成大量可执行的交互,持续扩充训练数据。
Molmo2 标注开放集目标。
无论场景来自哪里,引擎都利用带有实际尺度的深度信息,将图像中的点还原为三维位置,汇入统一目标库。
仿真器生成可执行的导航片段。
引擎批量采样目标与起点,规划路线、确定停止位置,并渲染第一视角视频。
VLM 生成并验证导航指令。
先由模板或视频 VLM 生成指令初稿,再进行语义检查与改写,最后用终点画面验证。
一次仿真交互→一组相互对应的多模态数据
场景素材还不能直接用于监督训练。引擎先识别可到达的目标,生成可执行路线,从不同第一视角渲染视频,再根据完整交互过程生成指令。先有路线、再有指令,可以确保语言描述对应的是场景中能够实际执行的行为。
经过对齐检查和数据配比检查,每段导航过程都形成一组同步数据,包含指令、历史画面、图像空间点和动作。第二阶段扩充的正是这样的训练记录。它们提供了对齐的具身经验,而不仅是场景或视频。
不同重建格式采用各自适用的标注方式,最终转换为统一的目标表示。
- 在可通行区域采样视点。
- 朝四个方向渲染 RGB 图像与带有实际尺度的深度图。
- 用 Molmo2 定位开放词汇目标。
- 将图像点还原为三维位置,并合并多视角结果。
已有三维包围框标注的场景无需重新检测物体,可直接转换为统一的目标表示。
将目标的三维位置投影到当前视图,得到目标点;在可通行空间中选取可通行点。
目标通过筛选后,引擎依据场景几何规划路线,再渲染沿途视频作为观测历史。相比之下,语言描述更容易出错,因此引擎采用两种指令生成方式,并进行两轮验证,确保视频、动作与指令彼此对应。
先生成动作轨迹,再配上语言指令;指令必须与既定目标和路线一致。
将方位分为八个扇区,据此生成包含目标信息的模板指令。
Seed2.0 生成基于视频的指令初稿。
统一两种来源的指令表达。
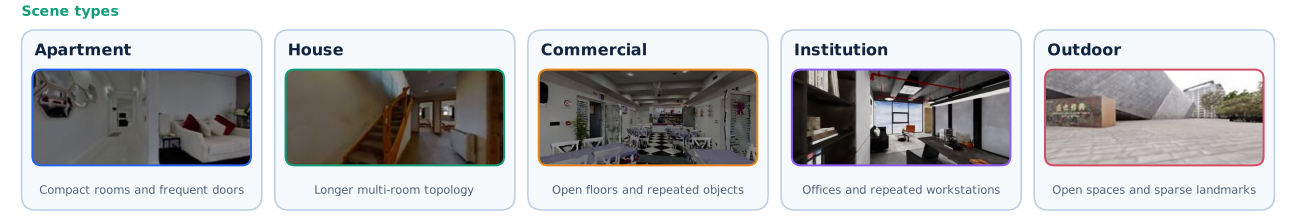
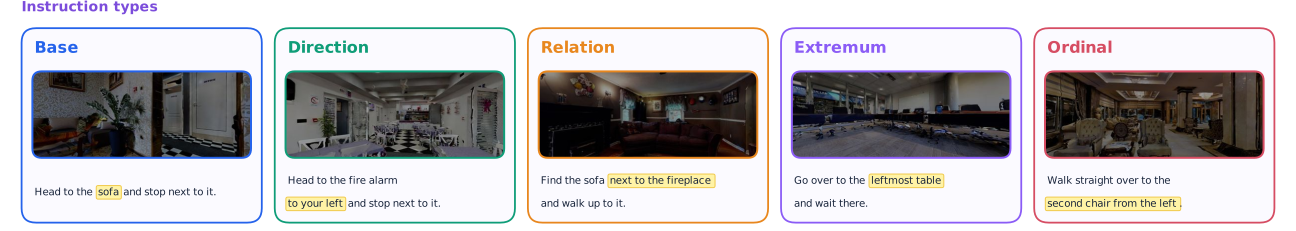
INSIGHT-Bench 提供了这套引擎中一部分可复现的数据:来自 1,683 个场景的 53,090 段训练片段,以及固定用于评测的 210 个场景、1,097 段片段。场景包含传统网格和高斯泼溅重建,导航片段覆盖五类场景与五种目标指代方式。
渲染器还通过改变相机参数增加数据多样性。在同一场景中,视场角的采样范围为 90–130° ,相机高度为 0.5–1.5 米,俯仰角为 −15° 到 15°。这样,模型在训练中就能接触不同本体尺度带来的视角变化,而不会只适应某一种相机配置。
不同数据源丰富画面外观;不同评测类别则检验指令中的不同空间推理要求。
- HM3D / MP3D
- 34,531 65.0%
- InteriorGS
- 8,534 16.1%
- HabitatGS
- 5,776 10.9%
- VLNVerse
- 4,249 8.0%
场景按功能与布局分类。指令类型由确定目标时所用的几何规则决定,而非根据生成后的关键词判断。
让空间理解转化为行动。
借助这些对齐数据,第一阶段学到的空间理解开始转化为导航行为。面对同一个语言目标和历史画面,模型同时学习判断:指令指的是哪个目标、哪里可以通行,以及沿哪条轨迹能够到达。这三个决策都由同一次交互提供监督,让感知与动作在训练中紧密联系。
训练以导航与动作样本为主,同时保留一部分推理数据,以维持第一阶段学到的空间能力。在第二阶段数据相同的情况下,以 LightNav-ER 为起点训练的模型在全部评测设置中都有提升(图 05–06)。空间理解通过简洁的输出形式转化为行动:Point CoT 用图像中的点表达空间意图,RVQ 动作 token 则编码接下来的轨迹。
第二阶段训练数据构成。
- 导航与动作样本
- 77.6%
- 视觉问答
- 22.4%
ER 初始化使八项评测全部提升。
从路线中学习目标定位与通行方向。
Real2Sim2Real 引擎为每帧保留目标、相机位姿和路线信息,因此可以在生成导航片段的同时自动生成点标注。将前方可到达的路径点投影到图像中,就得到可通行点;当目标进入视野时,将其三维位置投影到图像中,就得到目标点。轨迹数据增加,点监督也随之增加,无需单独的标注流程。
在可通行空间中选出的点。
在图像中定位指令所指的物体。
 三维包围框
机器人每一步决策都要进行推理,因此推理过程需要足够简短,训练标注也要便于批量生成。我们首先考虑过文本 CoT:它表达力强,但长度不固定、解码开销大,难以稳定合成;动作失败时,也很难客观判断推理是否正确。我们还考虑过带有实际尺度的三维目标,但这类标注依赖深度、位姿、相机标定和重建质量,也需要不同本体间统一的坐标系。
图像空间中的点提供了更直接的选择。每次决策只增加两个点 token:目标可见时,目标点标出指令所指的物体;可通行点则指出前进方向上的自由空间。两种标注都可以利用仿真几何批量生成。部署时,模型根据 RGB 和语言直接预测这些点,无需输入深度、定位、标定或地图信息。固定的输出格式使推理序列保持简短。
图 08 检验了这种表示是否有助于导航。在其余条件不变时,加入 Point CoT 使八项评测全部提升,平均 SR 增加 8.4,平均 SPL 增加 5.7。
Point CoT 使八项评测全部提升。
- 平均 SR
- +8.4
- 平均 SPL
- +5.7
- 提升设置数
- 8 / 8
用 token 表达动作。
模型学习预测的是一条由十个路径点(waypoint)组成、带有实际尺度的 SE(2) 轨迹。为了让轨迹与语言、图像空间点都能以 token 形式自回归生成,我们用第二阶段的轨迹数据训练残差向量量化器(RVQ),将整条轨迹编码为三个动作 token。
RVQ 采用三级码本,每级包含 256 个条目。L0 给出粗轨迹,L1 和 L2 依次编码剩余误差,逐步修正轨迹。三个 token 解码后的路径点平均位移误差为 0.72 厘米。消融实验表明,三级是满足精度要求的最小配置:减至两级,重建误差会明显增大;增加层级或扩大码本,精度提升则很有限。解码可以在任一级结束:仅用 L0 就能恢复一条完整的粗轨迹,加上后续 token 后再逐步细化。
在预测接口和第二阶段训练方案不变的基础上,我们分别增加训练环境、对齐 SFT 样本和模型参数,比较哪一种扩展方式能更稳定地提升导航能力。
增加训练环境,收益仍在持续。
在测试范围内,增加训练环境最能稳定地提升导航表现。每次扩大环境覆盖,四项指标都会提高。增大模型则有得有失;在同一批场景中继续增加 SFT 片段,提升幅度也逐渐减小。这说明,在当前规模下,引入新环境可能比在已有环境中生成更多样本更有价值。
Real2Sim2Real 让这样的扩展可以实现。真实场景完成一次重建后,就能反复生成相互对齐的目标、路线、指令和相机画面。增加算力可以提高导航片段的生成速度,增加场景素材则能丰富数据中的视觉外观与空间结构。
SFT 数据即使覆盖广泛,仍有局限:它展示了如何成功导航,却很少涵盖模型自身犯错后的恢复过程。转弯过晚、走过目标或跟丢目标,都会让模型遇到示范数据中少见的状态。第三阶段沿用相同的点与动作接口,但开始从另一类经验中学习:模型自行生成的轨迹及其执行结果。
在自主尝试中继续学习。
在线 RL 过程中的跟踪成功率
EVT-Bench 干扰跟踪(DT)评测,覆盖 101 个场景中的 1,392 段导航片段。
三个阶段分别利用空间推理数据、对齐的仿真交互数据,以及模型自主决策的仿真结果进行训练。接下来,我们检验这些训练带来的能力能否迁移。评测覆盖公开基准、真机本体和陌生的视觉环境。
R2R
SR ↑ · 60–80全部已报告方法11 单目 · 17 全景 / 多相机
单目方法
- LightNav-068.5单目
- Qwen-RobotNav-4B66.9单目
- Qwen-RobotNav-8B65.7单目
- CorrectNav65.1单目
- DualVLN64.3单目
- InternVLA-N158.2单目
- Qwen-VLA57.3单目
- StreamVLN56.9单目
- NaVILA54.0单目
- Uni-NaVid47.0单目
- NaVid37.0单目
全景 / 多相机
- Qwen-RobotNav-8B72.1全景 / 多相机
- Qwen-RobotNav-4B69.5全景 / 多相机
- ABot-N168.3全景 / 多相机
- ABot-N066.4全景 / 多相机
- SPAN-Nav66.3全景 / 多相机
- NavForesee66.2全景 / 多相机
- NavFoM61.7全景 / 多相机
- HNR61.0全景 / 多相机
- ETPNav57.0全景 / 多相机
- Reborn50.0全景 / 多相机
- GridMM49.0全景 / 多相机
- DreamWalker49.0全景 / 多相机
- AO-Planner47.0全景 / 多相机
- Sim2Sim43.0全景 / 多相机
- CMA41.0全景 / 多相机
- HPN+DN36.0全景 / 多相机
- InstructNav31.0全景 / 多相机
RxR
SR ↑ · 60–80全部已报告方法10 单目 · 12 全景 / 多相机
单目方法
- LightNav-073.6单目
- Qwen-RobotNav-8B73.4单目
- Qwen-RobotNav-4B71.3单目
- CorrectNav69.3单目
- DualVLN61.4单目
- Qwen-VLA59.6单目
- InternVLA-N153.5单目
- StreamVLN52.9单目
- NaVILA49.3单目
- Uni-NaVid48.7单目
全景 / 多相机
- Qwen-RobotNav-8B76.5全景 / 多相机
- Qwen-RobotNav-4B75.2全景 / 多相机
- ABot-N170.9全景 / 多相机
- SPAN-Nav69.7全景 / 多相机
- ABot-N069.3全景 / 多相机
- NavForesee66.3全景 / 多相机
- NavFoM64.4全景 / 多相机
- HNR56.3全景 / 多相机
- ETPNav54.7全景 / 多相机
- Reborn48.6全景 / 多相机
- CMA26.5全景 / 多相机
- Sim2Sim26.5全景 / 多相机
MP3D
SR ↑ · 40–60全部已报告方法5 单目 · 3 全景 / 多相机
单目方法
- LightNav-053.3单目
- CogNav46.6单目
- SG-Nav40.2单目
- OpenFMNav37.2单目
- VLFM36.4单目
全景 / 多相机
- Qwen-RobotNav-4B52.2全景 / 多相机
- Qwen-RobotNav-8B48.8全景 / 多相机
- WMNav45.4全景 / 多相机
HM3D v1
SR ↑ · 50–80全部已报告方法8 单目 · 1 全景 / 多相机
单目方法
- LightNav-074.5单目
- Uni-NaVid73.7单目
- CogNav72.5单目
- FiLM-Nav61.7单目
- TriHelper56.5单目
- SG-Nav54.0单目
- VLFM52.5单目
- OpenFMNav52.5单目
全景 / 多相机
- WMNav58.1全景 / 多相机
HM3D v2
SR ↑ · 60–85全部已报告方法4 单目 · 2 全景 / 多相机
单目方法
- LightNav-079.5单目
- FiLM-Nav77.0单目
- VLFM63.6单目
- SG-Nav49.6单目
全景 / 多相机
- Qwen-RobotNav-4B75.6全景 / 多相机
- Qwen-RobotNav-8B71.2全景 / 多相机
已见类别
SR ↑ · 40–65全部已报告方法5 单目 · 4 全景 / 多相机
单目方法
- LightNav-055.3单目
- MTU3D55.0单目
- Uni-NaVid41.3单目
- DAgRL+OD38.5单目
- VLFM35.2单目
全景 / 多相机
- Qwen-RobotNav-4B57.7全景 / 多相机
- Qwen-RobotNav-8B56.1全景 / 多相机
- ABot-N055.3全景 / 多相机
- NavFoM37.7全景 / 多相机
同义词
SR ↑ · 40–65全部已报告方法5 单目 · 4 全景 / 多相机
单目方法
- LightNav-053.3单目
- MTU3D45.0单目
- Uni-NaVid43.9单目
- DAgRL+OD39.0单目
- VLFM32.4单目
全景 / 多相机
- Qwen-RobotNav-4B60.1全景 / 多相机
- Qwen-RobotNav-8B57.8全景 / 多相机
- ABot-N055.4全景 / 多相机
- NavFoM43.3全景 / 多相机
未见类别
SR ↑ · 35–60全部已报告方法5 单目 · 4 全景 / 多相机
单目方法
- LightNav-047.0单目
- MTU3D40.8单目
- Uni-NaVid39.5单目
- DAgRL+OD37.1单目
- VLFM35.2单目
全景 / 多相机
- ABot-N054.0全景 / 多相机
- Qwen-RobotNav-4B53.1全景 / 多相机
- Qwen-RobotNav-8B51.2全景 / 多相机
- NavFoM43.6全景 / 多相机
单目标
SR ↑ · 85–95全部已报告方法5 单目 · 7 全景 / 多相机
单目方法
- LightNav-091.7单目
- ReferTrack89.4单目
- VLingNav88.4单目
- TrackVLA85.1单目
- Uni-NaVid53.3单目
全景 / 多相机
- CoMaTrack92.1全景 / 多相机
- ABot-N187.0全景 / 多相机
- ABot-N086.9全景 / 多相机
- TrackVLA++86.0全景 / 多相机
- NavFoM86.0全景 / 多相机
- Qwen-RobotNav-8B78.6全景 / 多相机
- Qwen-RobotNav-4B77.4全景 / 多相机
干扰跟踪
SR ↑ · 65–85全部已报告方法5 单目 · 5 全景 / 多相机
单目方法
- LightNav-082.6单目
- ReferTrack73.3单目
- VLingNav67.6单目
- TrackVLA57.6单目
- Uni-NaVid31.9单目
全景 / 多相机
- CoMaTrack74.2全景 / 多相机
- ABot-N066.7全景 / 多相机
- TrackVLA++66.5全景 / 多相机
- ABot-N165.2全景 / 多相机
- NavFoM61.4全景 / 多相机
重新思考导航评测。
多数导航基准用一个成功率综合衡量多种能力,场景又主要集中在 Habitat 一类平台使用的室内扫描环境中,指令往往是较长的路线描述。因此,当导航失败时,单一分数很难说明问题出在哪里:模型没有理解目标、没有识别空间关系,还是无法通过当前场景。
我们自建了 INSIGHT-Bench,用于分别检验这些能力。它围绕五种基本目标指代方式设计任务:基础指代、方向指代、空间关系、极值指代和顺序指代。评测覆盖公寓、住宅、商业空间、机构空间和室外环境。评测集包含 210 个未参与训练的场景,共 1,097 段导航片段。在统一使用前向 RGB 的评测条件下,LightNav-0 与其他六个开源策略相比,在每类指令和每类场景中都取得了最高成功率。
按指令类型
成功率 · 统一 0–70 刻度按场景类型
成功率 · 统一 0–70 刻度用零样本迁移检验具身后训练。
策略在一种机器人上有效之后,更严格的检验是:换了本体、场景或任务,学到的能力是否依然有效。我们从这三个方面评测 LightNav-0:四种真实机器人本体、未见过的室内外环境,以及长程指令跟随、开放词汇物体导航和目标跟踪三类任务。
超越机器人导航。
数据规模扩大的价值,要看模型能否适应训练环境之外的世界。为此,我们将同一个模型用于与机器人训练数据视觉风格显著不同的环境:先在交互式虚拟世界中进行闭环控制,再对真实场景视频进行开环预测。
两种测试关注不同能力。在交互世界中,模型的动作会改变下一次观测,错误也可能不断累积,检验的是完整的闭环策略。在预录视频中,模型无法改变后续画面,因此可以单独观察目标定位、可通行空间判断和轨迹预测能否适应不同的相机、运动方式与视觉风格。
在陌生世界中闭环控制。
不同环境带来不同挑战。体素世界的几何与纹理截然不同;驾驶世界要求在高速运动中持续转向,纠正偏移的时间更短;第一人称世界采用复古画面,最后一段还使用低分辨率的 4:3 画面,同时改变了图像分辨率和宽高比。
视频中的开环泛化。
山地骑行、速度滑冰、自由式滑雪和越野跑的视频,带来了后训练数据中未覆盖的快速视角运动、遮挡、目标尺度变化,以及不同于机器人视角的相机运动。面对这些画面,LightNav-0 仍能逐帧定位目标并预测可行的运动轨迹。
LightNav-0 正式开放。
本次发布包含 LightNav-0 的模型、代码、技术报告及 INSIGHT-Bench 评测工具。
感谢我们的合作伙伴逐际动力与群核科技在真机部署与仿真方面给予的支持。